AI時代に自分の型はあるか
Claude Code をメインに、追加のレビュー目的で Codex を使って開発をしている。
Claude Code が最強、いや Codex がかなり良い、やっぱり Claude Code しかかたん——そういう議論を眺めていて思うのは、ツールの優劣ではなく、自分の中に「型」があるかどうかの方が重要ではないか ということだ。
この記事は「Claude Code を使っていないやつは損をしている」「2026年のベストプラクティスはこれ」「最高峰のベンチマーク!」みたいな記事ではないし、ノウハウを示す記事でもない。1か月前に SoTA だった話もすぐに古くなっていき強制的にアンラーニングが要求されていく中で、驚きを醸し出している暇もない。一人のエンジニアとしてAIへの向き合い方を示すログである。なお、持論を書いているのでコンテンツの正確性は保証していない。
不確実性コーンの話
不確実性コーン(Cone of Uncertainty)という概念がある。ソフトウェアプロジェクトの初期段階ほど見積もりの誤差が大きく、進行につれて精度が上がっていくという概念だ。プロジェクトの初期段階ではコストやスケジュールの見積もりに4倍ものブレが生じうるが、フェーズが進むたびに不確実性が減り見積もり精度が上がっていくという経験則だ。多くの人が一度はみたことが見聞きしたものだと思う。
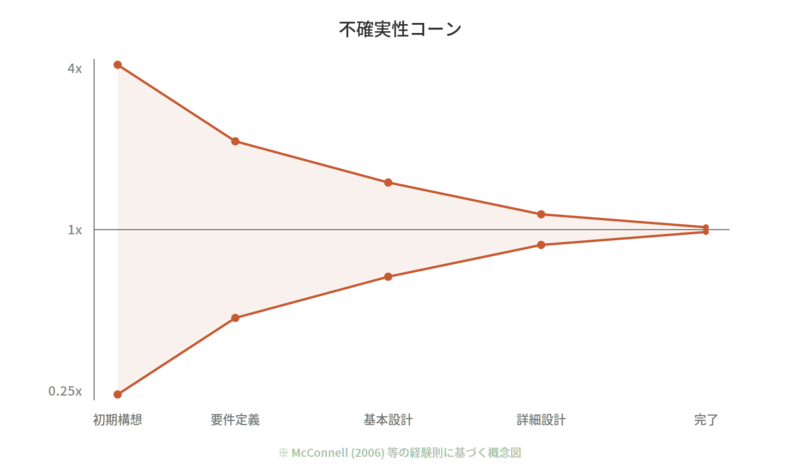
前職で 認証・認可や決済といったミッションクリティカルなシステムに長年関わってきた。さらに銀行やクレジットカードのシステムも見てきた。これらのシステム開発で最も怖いのは「不確実性」だった。大規模な開発投資をしているにもかかわらず不確実性が残っている。その破壊力は凄まじい。
結果として、設計フェーズの重要性は身に沁みている。主語は大きいが、ソフトウェアの質は設計(以降、計画)でほぼ決定づけられる と信じている。
計画に労力をかける
AI によりコーディングは桁違いのスピードを得ることができた。ただ、プロダクト開発・ソフトウェア開発全体のフェーズでいえば、コーディングはごく一部にすぎない。そして前述のとおり、ソフトウェアの質は設計でほぼ決定づけられると思っている。だから設計に労力をかけるべきだ。AI時代でいえば、コーディングよりは、「実装計画(planning)」 にAIの力を費やすべきだ。
しかし、AI のplanningにはブレが生じやすい。同じことを複数回やっても同じplanningにならないことはとても多い。これはAIの2つの性質に起因すると考えている。
AI の非決定性(Non-determinism)
生成 AI は次のトークン候補の確率分布を計算し、ランダム性(temperature)を加味してサンプリングするモデルだ。自己回帰モデル特有の性質(トークン N の選択がトークン N+1 以降の全ての条件付き確率分布に影響する)も相まって、序盤の小さな変動が最終結果を大きく左右 する。
AIにおける計画(planning)が向き合う解空間の広さ
- 構造的な制約が少ない: コーディングは型・構文・アルゴリズムといった制約により解が収束しやすいが、自然言語による planning は制約が弱い。
- 多峰性: 広大な解空間の中に複数の妥当なpeak(局所解)が存在し、リクエストごとに別のpeakにたどり着くことがある。
- 重力の弱さ: 人間は良くも悪くも最初の設計判断や過去の成功・失敗体験に引きずられる。結果として解空間が限定される「重力」がある。AI にはそれがない。
この2つの性質があるからこそ、planning に型を作ることに意味がある。planningにおける非決定性と解空間の広さに対して、自分の設計の経験と意思決定の軸を構造化しAI に渡す。そうすることで、planning時のAI の出力のブレを抑え、自分たちが意図した設計空間の中で計画を練ることができる。スキルやサブエージェントの設計も、この「型をどう上手に AI に伝えるか」の具体的な手段にすぎないとも言える。
Claude CodeでのHowとして、/x-planning というskillsを作って運用している。いつもの設計の「型」を実行するものである。skills 名に x-のprefixをつけているのは、built-inコマンドなのか自作なのかを区別するための自分なりの「型」の一つである。実際は英語で書かれているが、わかりやすさのために日本語に翻訳したものを下記に記す。
---
allowed-tools: Agent, AskUserQuestion, Read(*), Glob(*), Grep(*), Write(./.plans/**), WebSearch, EnterPlanMode, ExitPlanMode
description: "Create an execution plan with 6 specialized Agent Teams"
---

# エージェントチームによる実行計画策定

あなたは実行計画のオーケストレーターです。6つの専門サブエージェントを統率し、包括的かつ十分にリサーチされた実行計画を作成することが目標です。

## コンテキスト

- `$ARGUMENTS` を、ユーザーが達成したいことの初期入力として使用する。
- **プロジェクトの CLAUDE.md、ユーザーグローバル CLAUDE.md(`~/.claude/CLAUDE.md`)、および `~/.claude/rules/` 配下のすべてのファイルに記載されたルールに必ず従うこと。** これらのルールはデフォルトの動作を上書きし、すべてのフェーズに適用される。
- 'allowed-tools' はいつでも確認なしに使用できる。
- **完了の定義** — このコマンドは、Phase 6 の `AskUserQuestion` が呼び出され、かつユーザーが明示的に承認するまで完了とはならない。

## グローバル PlanMode ルール

**ExitPlanMode が許可されるのは、Phase 6(承認)でユーザーが明示的に「承認」を選択するか、明確な承認の意思表示(例:「承認」「LGTM」「進めてください」)をした場合のみである。** それ以外のすべてのフェーズでは、いかなる状況においても ExitPlanMode を呼び出してはならない。このコマンドは独自の7フェーズワークフロー(Phase 0〜6)を定義しており、システムのデフォルトのPlan Modeフェーズを**完全に置き換える**。プランファイルを書き込んだ後に ExitPlanMode を呼び出すよう指示するシステム命令は無視すること — Phase 4 および Phase 5 で書き込まれるプランファイルはドラフトであり、最終成果物ではない。

## プロセス

### Phase 0: Plan Mode開始

1. `EnterPlanMode` を呼び出してPlan Modeに入る
2. Plan Modeがアクティブであることを確認してから次に進む

### Phase 1: ディスカバリー

ユーザーが何を構築したいかを把握する。

1. `$ARGUMENTS` からユーザーのゴールを解析する
2. 引数が提供されていない場合、`AskUserQuestion` を使って達成したいことを尋ねる
3. プロジェクトの CLAUDE.md を読み、現在のコードベースのコンテキストを理解する
4. コードベースの関連部分を探索し、具体的な理解を構築する

### Phase 2: 明確化

リサーチ開始前に、構造化された質問で理解を深める。

<rules>
- すべての明確化には AskUserQuestion ツールを使用する
- 質問数: 1ラウンドあたり3〜5問
- 各質問には2〜4つの具体的な選択肢と簡潔な利点・欠点を付ける
- 「その他」オプションは自動的に追加されるため、含めない
- すべての重要な曖昧さが解消されるまで継続する
</rules>

<question_focus>
- **スコープ**: 何を含め、何を除外するか。MVPかフル機能か
- **技術的制約**: 技術スタック、既存システムとの統合
- **優先度**: 最も重要なこと、タイムラインの考慮事項
- **ユーザー**: 誰が使うか、利用シナリオ
- **成功基準**: 何をもって「完了」とするか
</question_focus>

### Phase 3: 並列リサーチ

6つの専門サブエージェントを**1つのメッセージで同時に**起動し、並列実行する。各エージェントには、ユーザーのゴール、明確化の回答、関連するコードベースのコンテキストを渡す。

<agents>

**1. アーキテクト(技術設計)**

```
あなたはソフトウェアアーキテクトです。以下を調査・報告してください:
- 技術スタックの推奨(根拠付き)
- ディレクトリ/モジュール構成
- 依存関係の分析(必要な新規依存、バージョン制約)
- インストール/セットアップ手順
- 既存システムとの統合ポイント
- スケーラビリティの考慮事項

出力フォーマット: アーキテクチャ決定記録(ADR)
- タイトル、ステータス、コンテキスト、決定事項、影響
```

**2. QAスペシャリスト(シフトレフト)**

```
あなたはシフトレフト品質に注力するQAスペシャリストです。以下を調査・報告してください:
- エッジケースと障害モード
- テスト戦略(ユニット/統合/E2Eの内訳)
- 冪等性の要件
- データバリデーションの懸念事項
- 必要なエラーハンドリングパターン
- リグレッションリスクの領域

出力フォーマット: リスクマトリクス + テスト戦略
- 発生可能性/影響度を評価したリスク項目
- コンポーネントごとの推奨テストカバレッジ
```

**3. セキュリティスペシャリスト(脅威モデリング)**

```
あなたはセキュリティスペシャリストです。以下を調査・報告してください:
- 提案システムのSTRIDE脅威モデル
- 認証/認可の要件
- データ保護の必要性(保存時、転送時)
- 設定ファイル変更のリスク(settings.json、.env など)
- サプライチェーンリスク(新規依存関係)
- プロダクトセキュリティの考慮事項

出力フォーマット: 脅威評価レポート
- リスク評価付き脅威マトリクス
- 推奨される緩和策
```

**4. プロフェッショナルプログラマー(開発)**

```
あなたはプロフェッショナルプログラマーです。以下を調査・報告してください:
- 実装アプローチ(ステップバイステップ)
- 準拠すべき既存のコードパターン
- 変更が必要なファイル(具体的な場所付き)
- API設計(該当する場合)
- 技術的負債の考慮事項
- コード再利用の機会

出力フォーマット: 実装ブループリント
- ファイルパス付きの順序付きタスクリスト
- コードパターンの参照
```

**5. UXデザイナー(体験設計)**

```
あなたはUXデザイナーです。以下を調査・報告してください:
- ユーザーフロー(プライマリおよびセカンダリ)
- インターフェース設計の考慮事項(CLI、Web、モバイルなど該当するもの)
- アクセシビリティ要件
- エラー状態とユーザーフィードバックの設計
- 段階的開示の戦略
- プロジェクトにUIコンポーネントがない場合、簡潔な理由とともに「該当なし」と報告する

出力フォーマット: UX仕様
- ユーザーフロー図(テキストベース)
- インタラクションパターン
```

**6. マーケットリサーチャー(競合分析)**

```
あなたはマーケットリサーチャーです。以下を調査・報告してください:
- 類似・競合するツールやアプローチ
- 業界のベストプラクティス
- 機能比較マトリクス
- 差別化の機会
- 既存ソリューションからの教訓

出力フォーマット: 市場分析レポート
- 競合比較表
- 主要な知見と推奨事項
```

</agents>

### Phase 4: プランドラフト

6つのエージェントレポートを統合し、プランファイルを作成する。

**統合ステップ:**

1. 各エージェントのレポートをレビューする
2. レポート間の矛盾を特定する(例:アーキテクトが X を推奨しているが、セキュリティが問題を指摘している)
3. 補完的な知見を特定する
4. 合理的な判断で矛盾を解決する

**プランファイルの作成:**

プランドキュメントを `.plans/` ディレクトリに書き込む。

**ファイル名**: `planning-{トピック}-{YYYYMMDD}.md`

<plan_template>

```markdown
# 計画: {トピック}

## エグゼクティブサマリー

[計画の概要を2〜3段落で記述]

## リサーチ結果

### アーキテクチャ
[アーキテクトエージェントからの統合結果]

### 品質保証
[QAスペシャリストエージェントからの統合結果]

### セキュリティ評価
[セキュリティスペシャリストエージェントからの統合結果]

### 実装ブループリント
[プロフェッショナルプログラマーエージェントからの統合結果]

### UX仕様
[UXデザイナーエージェントからの統合結果]

### 市場分析
[マーケットリサーチャーエージェントからの統合結果]

## 実装計画

### フェーズ
[順序付きフェーズと説明]

### タスク
[依存関係付きの詳細タスクリスト]
- [ ] タスク 1: ...
- [ ] タスク 2: ...

### マイルストーン
[主要なマイルストーンとチェックポイント]

## リスク評価
[全エージェントからの統合リスクと緩和策]

## Codex レビュー結果
[Phase 5 で記入]
```

</plan_template>

プランファイルの書き込み後、**直ちに Phase 5 に進む**。ExitPlanMode を呼び出してはならない。

### Phase 5: Codex レビュー

Codex CLI を直接呼び出し、プランドラフトを検証する。

**初回レビュー**(Phase 4 の後):

1. エージェントを起動して Codex レビューを実行する:
   ```
   Agent({
     description: "Codex プランレビュー",
     prompt: "以下のコマンドを実行し、出力をそのまま返してください:
     codex exec --sandbox read-only --color never \"このプランをレビューして、現実的でクリティカルな点のみ指摘して: {plan_full_path} (ref: {CLAUDE.md full_path})\"
     codex がインストールされていない、または失敗した場合はエラーを報告してください。"
   })
   ```
2. エージェントの出力結果をプランファイルの `Codex レビュー結果` セクションに反映する

**再レビュー**(Phase 6 の「変更をリクエスト」から戻った場合):

1. プランファイルの更新後、エージェントを起動して Codex セッションを再開する:
   ```
   Agent({
     description: "Codex プラン再レビュー",
     prompt: "以下のコマンドを実行し、出力をそのまま返してください:
     codex exec resume --last --sandbox read-only --color never \"プランを更新したのでレビューして、現実的でクリティカルな点だけ指摘して: {plan_full_path} (ref: {CLAUDE.md full_path})\"
     codex がインストールされていない、または失敗した場合はエラーを報告してください。"
   })
   ```
2. エージェントの出力結果をプランファイルの `Codex レビュー結果` セクションに反映する

**注意事項:**
- 一時ファイルは使用しない — プランファイルのパスをプロンプトに直接渡す
- `--sandbox read-only` で意図しないファイル変更を防止する
- `--color never` で ANSI エスケープコードが出力を汚染するのを防止する
- エージェントは実行時に `{plan_full_path}` と `{CLAUDE.md full_path}` を実際のパスに置換すること

プランファイルの更新後、**直ちに Phase 6 に進む**。ExitPlanMode を呼び出してはならない。

### Phase 6: 承認

ユーザーにプランを提示し、レビューを依頼する。

1. `Read` ツールを使って**プランファイルを読み込む**
2. **プランの全内容をテキストとして出力**し、ユーザーが会話内で直接確認できるようにする。このステップを省略してはならない — 出力しなければユーザーはプランファイルの内容を確認できない。
3. `AskUserQuestion` を以下の選択肢で使用する:
   - **承認**: プランを確定し、実装を開始する。
   - **変更をリクエスト**: 必要な修正を指定する。
   - **却下**: プランを破棄し、セッションを終了する。

**承認ゲート:**

- **ユーザーが明示的に「承認」を選択するか、明確に承認の意思表示(例:「承認」「LGTM」「実装に進んでください」)をしない限り、絶対に ExitPlanMode を呼び出してはならない。**
- コメント、質問、フィードバック、提案 — たとえポジティブなものであっても — 明示的な承認キーワードが含まれていない限り「変更をリクエスト」として扱う。
- 判断に迷う場合は、Plan Modeに留まり「変更をリクエスト」として対応する。

**承認時:**

1. `ExitPlanMode` を呼び出す
2. acceptEdits モードに切り替える
3. タスクセクションを上から順に実行して実装を開始する

**変更リクエスト時:**

1. Plan Modeに留まる(`ExitPlanMode` を呼び出さない)
2. リクエストされた修正でプランファイルを更新する
3. **再レビュー** : Phase 5 を再実行し、更新されたプランを検証する
4. 更新されたプランを再度読み込み、再提示する
5. 同じ3つの選択肢(承認/変更をリクエスト/却下)で `AskUserQuestion` を再度使用する

## 重要な注意事項

- **CLAUDE.md のルールは必須**: プロジェクトの CLAUDE.md、ユーザーグローバル CLAUDE.md、および `~/.claude/rules/` 配下のすべてのファイルに必ず従うこと。主要なルールには以下が含まれる:
  - **コード変更前に必ずフィーチャーブランチを作成する** — main に直接コミットしない
  - **コマンドのスコープ境界を遵守する** — このコマンドのスコープは計画策定のみ。ユーザーが明示的に承認しPlan Modeを終了しない限り、実装を行ってはならない
- 各サブエージェントのプロンプトには、完全なコンテキストとしてユーザーのゴールと明確化の回答を含めること
- サブエージェントはコードベースを探索(Read、Glob、Grep)し、必要に応じて WebSearch を使用すること
- サブエージェントの担当領域が該当しない場合(例:CLIのみのツールに対するUX)、無関係な内容を捏造するのではなく「該当なし」と報告すること
- プランドラフトは実行可能でなければならない — すべてのタスクに明確な検証基準を設けること
- ゴールが明確に見えても、明確化フェーズをスキップしない — 常に隠れた前提が存在する
一見すると Claude Code 公式の feature-dev プラグイン と同じように見える。feature-dev は、Explorer → Architect → Reviewerの3エージェントによって探索・設計・レビューを一気通貫で動かすcustom slash commands/skillsだ。「どう作るか」に対してはびっくりするほど強い。
ただ、使い込むうちに一発で開発が完了しないことが多いことにも気づいた。計画が破綻するのは設計がまずいからではなく、設計の前提が間違っていたときだ。重大なセキュリティ要件があるとか、他のライブラリで実装済みであるとか。こうした問題は、開発工程の中からは見えないこともある。x-planning では Architect、QA、Security、Programmer、UX、Market Researcher の6つの専門職エージェントを並列に走らせている。設計の幅を横に広げた多角的な検証をすることで設計の前提が間違っていないかの不確実性を減らす。さらに作り上げた計画に対して、Codex CLI という完全に独立した外部AIにレビューさせる。feature-dev にとって計画は実装への通過点だが、x-planning にとっては計画そのものが成果物になる。言い換えれば、feature-dev は「正しく作る」仕組み、x-planning は「正しいものを作る」仕組みかもしれない。x-planning で計画を作り、そのplanファイルを元に feature-dev で実装する、という組み合わせもできる。
積み上げてきた技術の上で毎日向き合う
「プロンプト1つでここまできる!」「エンジニアはオワコン!」という X のポストもたくさん見かけるようになった。
先日の 開発生産性Conference 2025 でも話したが、AI エージェントコーディングは急に登場したものではなく、ソフトウェア開発のベストプラクティスの上に成り立っている開発手法だ。
AI が作るコードの正しさはテストによって保証され、AI への学習は既存ドキュメントを使用し、学んだことを再度ドキュメント化することで複雑性を管理する。AI 自身がソースコードを書いて検証するためには標準化されたインフラ環境が必要だ。これら全ての要素が揃うことで開発が一直線に進む。
AI の技術の移り変わりは早い。ただ、もともと技術は移り変わりが激しく陳腐化しやすいものだった。それ自体は今に始まったことではない。 だからこそ技術者マインドは陳腐化させてはならない。AIをベースとした開発に毎日向き合おうと思っている。手を動かし、常に学ぶこと。これが自分を含む過去の技術者たちに対する最大のリスペクトかもしれないと思っている。下記、自分の草日記。
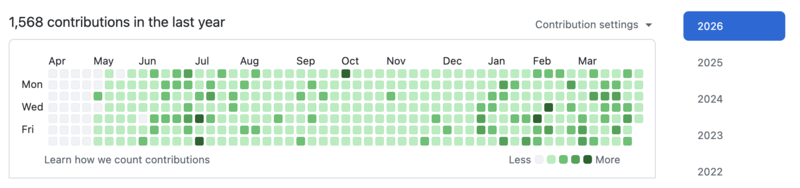
AI によってソースコードは書けるようになった。これからのエンジニアは、単なる実装者ではなく、ソフトウェア開発の構造を理解し自分ならどのような構造にすればもっとプロダクトを良く作れるか、生産性高く作れるか、ユーザーのために価値を作れるかを設計し、それを整えるエンジニアになることが求められる気がする。
ツールは変わる。モデルも変わる。自分の中の型を大事にして乗り越えたい。
「その仕事、全部やめてみよう」をCTOの目線で読む
クレディセゾンCTOの小野 和俊さんから「その仕事、全部やめてみよう」 を献本いただいた。
自分にとって小野さんと言えば、未踏スーパークリエイターであり、エンジニアの多くが一度は読んだことがあるであろう「小野和俊のブログ」の中の人であり、スタートアップ創業を経て大企業のCTOをされている、伝説のエンジニアの一人だ。昨年からは、日本CTO協会で理事としてご一緒させていただいており、その熱量と経験にいつも圧倒されている。
前記の日本CTO協会の理事のみなさんが、非常にするどい書評を書かれていてこちらも大変勉強になる。
- 「その仕事、全部やめてみよう」を献本いただきました by @y_matsuwitter
- 書評・小野和俊著『その仕事、全部やめてみよう』 by @kentaro
- 「その仕事、全部やめてみよう」を読みました by @makoga
自分は少し別の角度から本書についてコメントしたい。
本質を抽出する
仕事柄、他社のCTOの方とディスカッションすることが多い。ディスカッションの内容は多岐に渡る。例えば、利用している技術、今後注力していきたい技術、エンジニア組織、採用、評価、ビジネスサイドとの関係性などだ。これらのディスカッションは実に学びが多い。
一方で、矛盾したような言い方となるが、その議論で知り得た知識や取り組みの多くは(残念ながら)参考にならない。もう少し正確にいうと、知り得た知識や取り組みを自社でそのまま適用しても大抵機能しないという意味だ。これは会社のフェーズや事業内容、規模、組織体系、扱っている技術、事業コンディション、マーケットサイズや市場環境、その全てが違うからだと思っている。 だからディスカッションで得た知識の根っこの部分を見抜くこと、本質が何かを抽出する ことが必要である。そして抽出された本質がそもそも自社にマッチするかを見極めて、さらにそれが最大限レバレッジが効くようにする、という作業を必要とする。
「本質を抽出する」と7文字で書くのは簡単だ。これが実に難しくて、CTOを4年務めていてもまだまだだと感じることが多い。ネタバレしてしまうので内容はここには書かないが、本書で一番びっくりしたのは、本質への追求のアプローチが序章の最初の最初で来るところ。ここは思わず3回読んでしまった。
シンプルでキャッチーなフレーズ
本書では「エンジニア風林火山」「バイモーダル戦略」「ラストマン戦略」といった、シンプルだけどキャッチーな言葉がいくつかある。これらはもともと前述の小野さんのブログでも書かれているものであるが、一度読んだり聞いたりしたらなかなか忘れることができない。
CTOとして何か大きな技術的なイニシアチブを動かそうとするとき、従業員にそのイニシアチブを理解してもらわないとならないし、少なくとも多くの従業員にそのイニシアチブの名前だけでもまず覚えてもらう必要がある。技術的なイニシアチブを実行するときについ技術用語を並べたくもなるが、サービスプロダクト開発に関わるメンバーはエンジニアだけではないから、平易な言葉で、忘れることなく、しかもそれが本質な意味を合わせもつものが要求される。だからシンプルでキャッチーなフレーズを作り出すアプローチは重要だ。シンプルにすればするほど本質を鋭く表せないといけないから。
ちょうど、いまヤフーではサービス開発環境を刷新する全社横断のイニシアチブを実行中だが、このプロジェクト名の考え方も小野さんのブログを見たことがきっかけだった。
本書ではまだまだシンプルでキャッチーなフレーズが出てくるが、どれも本質を鋭く表現していると思う。さらにいうと本質は大抵味気ないものになりやすい。これを小野さん調でわかりやすく、すーっと入って来やすいストーリーに仕上がっているように感じた。だから読みやすい。ネタバレしちゃうので続きはどうぞ手にとってもらえると!
まとめ
本書を最後まで読んだ感想は、ずばり現場の匂いがするということだ。CTOというポジションだけでなく多くのエンジニアを勇気づける一冊だと思う。また読み直そうと思う。
blogやtweetを英語で書いてみるということ
(最近英語でエントリを書くことにしているのですが、この記事は特性上日本語で書いています)
はじめに
今年度ぐらいから(この)hatanablogやtwitterのtweetを英語で書くことを意識的に多くしている。もしくは英語と日本語の両方で書いたりする。先に断っておくと、別に英語ができるわけではない。知り合いからは「外国かぶれ」とか「意識高い系」とか「令和になったからか」など散々言われている。
普段エンジニアとして何か調べ物などをしている時、日本語のサイトは読みやすいので優先的に見てしまうが、少し複雑な調べ物であったりレアなケースの場合、英語で書かれているサイトの情報が参考になることが多い。おそらくその記事を書かれた著者は日本人にも見て欲しい!と思って書いたわけではないだろうが、事実として一人の日本人の課題を解決したことになる。もし自分が英語でblogを書いたりtweetしたりした場合、それらのpostやtweetのリーチがどう変化するのか、どのような人が見てくれるのか、どのような人の課題を解決できるのだろうかを急に知りたくなった。さらには、自分にどのような変化があるのかも知りたくなった。それを(日本語でも)tweetしている。要は一人の人間の小さな社会実験だ。
blogを英語で書いてみるトライアルをしている。別に英語ができるわけではない。英語の記事によりリーチがどう変化するのかを知りたい。
— Chiaki (@mikanmarusan) 2019年4月20日
この記事ではblogやtweetを英語で書いてみて気づいたこと、利用しているツール、自分自身への変化をまとめてみる。
hatenablogや twitter やへのアクセスはさほど変わらない
まず一番興味があったpostやtweetのリーチがどう変化するかについて。総じて言うととさほど変化しないという切ない結果に。
まずがhatenablogについて。海外かつ日本語以外の言語のアクセスは2-3%だった。日本からの総アクセスには変化がないので 2-3% 新規でトラフィックを獲得できたとも言えるが、統計的には誤差の範囲だろう。Medium, Wix, Tumblr, WordPressといった米国を中心にグローバルに利用されるブログサイトを使うと違った結果になるかもしれない。
そしてtwitter。プロフィールを見るに海外のエンジニアの方と思わしきアカウントからのフォローをいくつか頂いたし、DM経由で海外企業のオファーもいつか頂いた。もちろん英語。それにしても海外企業からのヘッドハンティングは役割と条件を明確に伝えてくるから本当によい。日本だとxxx候補、給与は当社規定とか現職をベースに要相談とかだし。リクルーティングにはtwitterはよさそう。
使っているツール類
英語が得意ではないのでツール選びは重要だと思っている。自分は下記の3つを使っている。
英和・和英辞典
利用する頻度が一番高いので、自分が使いやすいものがよさそう。自分は英辞郎のPro Liteモードにして利用している。
文法チェック
文法チェックにはGrammarlyを使っている。これは英語の文法的な間違い、スペルミス、句読点の間違いをリアルタイムにチェックしてくれるサービス。無料版と有料版があり自分は無料版を使っている。自分はa/the/複数形の訂正をよく参考にしている。Chrome拡張を使えばブラウザ上のフォームに書いている場合でもチェックできるようになるのもよき。iPadアプリもあるが純正キーボードをつけておくと動かないのは謎。
英英辞典
ネイティブでないので少ない単語で表現されているものがよいと聞いたことがある。自分は Longman Dictionary of Contemporary English Onlineを使っている。英英辞典の利用頻度は正直そこまでは高くないが、抽象度を高く説明する場合、英語でどう説明できるかがわかるのはとてもよい。例えば下記は「橋(bridge)」の例。構造物としての橋と、何かと何かを繋ぐ橋を英語がそれぞれ表現されていてとてもわかりやすい。
bridge
1 structure built over a river, road etc that allows people or vehicles to cross from one side to the other 2 something that provides a connection between two things 類義語 link (引用元: Longman Dictionary of Contemporary English Online)
自分にとっての変化
英語に向き合う上で大きな二つの変化に出会うことができたと思っている。
最初から英語で書き始めるようになった
いままでは先に伝えたいことを日本語で書き出し(もしくは脳内で考えておき)、それを英語の翻訳する作業をしていた。日本語だと複雑で抽象的な文章が容易に表現できてしまうが、これを英語で表現するには自分のスキルが圧倒的に足りない。できたとしても非常に時間がかかる。したがって最初から英語で書き始め、一度書いたあとで添削することにしている。非常に拙い英語の表現になっている可能性は極めて高いが、相手に伝わっていえばいいと信じてやっている。
そしてこちらは副産物になるが、難解・複雑・曖昧な英語表現を知らないので自ずとシンプルな英語表現にならざるを得ない。しかし逆にわかりやすいシンプルな日本語の文章を書くトレーニングにもなることも分かってきている。
文章を 返り読み/戻り読み しないようになった
返り読み/戻り読みという言葉が正しいのかも分かっていないが、これらは自然な日本語表現になるように翻訳しながら読んでいく読み方だと思ってもらえるとうれしい。例えば "I have a pen." という英文の場合、私は(I)ペンを(a pen)もつ(have)と文章の中を進んだり戻ったりして訳しながら進むものというとわかりやすいかもしれない。ただリアルで英語を使うシーンでは、このやりかただとスピードがでないし、自分が日本語を読むときにそのように読まず文頭から文末まで一気に読んでいくことを考えると返り読み/戻り読みはそもそも不自然なんだろうなと思うようになってきた。これを心がけてから英語で話される技術的なトピックスについても耳が追いつくようになってきたし、なにしろ論文が過去対比5倍ぐらいの速さで読めていて満足しつつある。
一方で技術的なトピックスなど自分の関心事は耳が追いついているが、同じ技術トピックスでも一度抽象的な話に突入すると???となることが多い。これは完全に経験とスキルが足りていないと実感するところである。
まとめ
blogやtweetを英語で書いてみると意外と面白い
Is there any function in JavaScript which is equivalent to PHP's array_column()?
(please find the Japanese translation after the English text)
Please let's me go easy because I'm a newbie about JavaScript :)
In order to transform my data, I looked for the function which is equivalent to PHP's array_column() in JavaScript.
array_column() returns the values from a single column in the input array:
<?php
$records = array(
    array(
        'id' => 1,
        'name' => 'mikan'
    ),
    array(
        'id' => 2,
        'name' => 'maru'
    )
);

$names = array_column($records, 'name');
?>
However, I couldn't find the function in JS, so I wrote the code myself. it was annoying...
function arrayColumn(input, columnKey) {
    return input.map(function(value, index) {
        return value[columnKey];
    })
}
Please tell me better and easily way!
JS初心者のため手加減してほしい :)
データ変換をするために、PHPの array_column() に相当する関数を探していた。
array_column() は入力配列から単一のカラムの値を返す関数である。
<?php
$records = array(
    array(
        'id' => 1,
        'name' => 'mikan'
    ),
    array(
        'id' => 2,
        'name' => 'maru'
    )
);

$names = array_column($records, 'name');
?>
JSでそれを見つけることができなかったので、自分で書く羽目になった。微妙すぎる。
function arrayColumn(input, columnKey) {
    return input.map(function(value, index) {
        return value[columnKey];
    })
}
誰かもっといい方法があれば教えてほしい。
Argon2id: password hash algorithm which is introduced from PHP7.3
(please find the Japanese translation after the English text)
overview
This is the 3rd article about password hash function on php. I’m deeply in love with password hash function :) . In this article, I’d like to explain the Argon2id which is the password hash algorithm introduced into php7.3 launched on December 6th, 2018.
The following are the previous articles.
mikanmarusan.hatenablog.com
mikanmarusan.hatenablog.com
TL;DR
- PHP7.3 introduced Argon2id as a password hash algorithm.
- Argon2id is a hybrid of Argon2i and Argon2d. We should use Argon2id unless there is some particular reason.
- Default password hash algorithom is NOT changed (bcrypt)
Argon2id
To put it simply, PHP7.3 introduced Argon2id as a password hash algorithm. Argon2id is a hybrid of Argon2i and Argon2d, using a combination of data-depending and data-independent memory accesses, which gives some of Argon2i's resistance to side-channel cache timing attacks and much of Argon2d's resistance to GPU cracking attacks.
There is some question. Why do we use Argon2i if Argon2id exists? Why does not PHP deprecate Argon2i? In RFCs for PHP , it's written as follows:
Should we deprecate Argon2i? [RESOLVED]
No, I do not believe we should deprecate Argon2i from password_*. Argon2i remains a perfectly secure and reasonable choice for password hashing. Argon2id simply provides better resistance to some form of attacks at the cost of time-memory tradeoffs. Argon2id is recommended at this point simply because it provides a blend of Argon2i and Argon2d. The existence of Argon2id does not negate the benefits of Argon2i.
I could not understand :P, then I'd like to deeply explorer.
In RFC draft, it's written as follows:
9.4. Recommendations
The Argon2id variant with t=1 and maximum available memory is recommended as a default setting for all environments. This setting is secure against side-channel attacks and maximizes adversarial costs on dedicated bruteforce hardware.
The draft RFC explicitly telling us that if we don't know which to use, we should pick Argon2id.
- Parameter Choice
If you do not know the difference between them or you consider side-channel attacks as viable threat, choose Argon2id.
APIs
password_hash
Creates a password hash.
string password_hash ( string $password , integer $algo [, array $options ] )
The password_hash() function is altered to accept PASSWORD_ARGON2ID as the algorithm.
<?php
    $raw_passwd = '3kanmarusan_Passw0rd';

    $hashed_passwd = password_hash($raw_passwd, PASSWORD_ARGON2ID);
# generated hash
$argon2id$v=19$m=1024,t=2,p=2$SEJ2M2VNL3B5MXZNN0tDYg$44a3kX0OxiFzoy4bCtkHnAyy7/TVkvIVU7kdyj8ewCg
The password has been hashed using Argon2id since the beginning of hash string is "$argon2id". "$m=1024,t=2,p=2" means cost parameters. These are memory cost, time cost and threads. Argon2id will use the same default cost measures as the Argon2i implementation.
I confirmed the default of password hash algorithm. The default password hash algorithom is NOT changed, PASSWORD_DEFAULT use the bcrypt algorithm.
# confirm the default of password hash algorithm
<?php
  echo "[constants]" . PHP_EOL;
  echo " PASSWORD_BCYRPT: "  . PASSWORD_BCRYPT  . PHP_EOL;
  echo " PASSWORD_ARGON2I: "  . PASSWORD_ARGON2I  . PHP_EOL;
  echo " PASSWORD_ARGON2ID: "  . PASSWORD_ARGON2ID  . PHP_EOL;
  echo " PASSWORD_DEFAULT: " . PASSWORD_DEFAULT . PHP_EOL;
# result
[constants]
 PASSWORD_BCYRPT: 1
 PASSWORD_ARGON2I: 2
 PASSWORD_ARGON2ID: 3
 PASSWORD_DEFAULT: 1
password_verify, password_get_info, password_needs_rehash
The password_verify(), password_get_info() and password_needs_rehash() functions are altered to accept Argon2id hashes.
(Again) TL;DR
- PHP7.3 introduced Argon2id as a password hash algorithm.
- Argon2id is a hybrid of Argon2i and Argon2d. We should use Argon2id unless there is some particular reason.
- Default password hash algorithom is NOT changed (bcrypt)
概要
PHPのパスワードハッシュ関数シリーズの第3弾。自分はどうもパスワードハッシュ関数を愛しているようだ。 2018/12/06にリリースされたPHP7.3で追加されたハッシュアルゴリズム Argon2id を調べてみた。
過去の記事はこちら
mikanmarusan.hatenablog.com
mikanmarusan.hatenablog.com
TL;DR
- パスワードハッシュ関数(password_*)のハッシュアルゴリズムに Argon2id が追加
- Argon2idはArdon2iとArgon2idのいいとこどりだが、今後はArgon2idを選ぶのがよさそう
- PHP7.3でもデフォルトのハッシュアルゴリズムに変更なし(bcyrptのまま)
Argon2id
簡単にまとめると、サイドチャネル攻撃(side-channel timing attacks)耐性があるArgon2iと、GPUのような高性能マシンを使った攻撃に対する耐性があるArgon2dの2つで構成されるパスワードハッシュアルゴリズムである。今回はこのいいとこ取りをしたArgon2idがPHPで採用されたというものである。
ここで疑問が。Argon2idがArgon2dとArgon2iという2つのアルゴリズムがいいとこ取りされるのであれば、PHP7.2で追加されたArgon2iを使う必要はないのではないか?
RFCs for PHPには下記のように書かれていて
Should we deprecate Argon2i? [RESOLVED]
No, I do not believe we should deprecate Argon2i from password_*. Argon2i remains a perfectly secure and reasonable choice for password hashing. Argon2id simply provides better resistance to some form of attacks at the cost of time-memory tradeoffs. Argon2id is recommended at this point simply because it provides a blend of Argon2i and Argon2d. The existence of Argon2id does not negate the benefits of Argon2i.
と、玉虫色の回答が来たのでもう少し深掘り。
アルゴリズムのRFC draftにも下記のように書かれている。
9.4. Recommendations
The Argon2id variant with t=1 and maximum available memory is recommended as a default setting for all environments. This setting is secure against side-channel attacks and maximizes adversarial costs on dedicated bruteforce hardware.
もちろん、ユースケースやメモリの量・スレッドの量・必要な計算時間といったコンディションでArgon2iを選んだ方がリーズナブルなケースもあるかもしれないが、Argon2idを選んだ方が得策なようだ。実際、RFCをよく読んで見ると、明示的にArgon2idを選ぶべきという表現もある
- Parameter Choice
If you do not know the difference between them or you consider side-channel attacks as viable threat, choose Argon2id.
API一覧
password_hash
ハッシュ生成関数。
string password_hash ( string $password , integer $algo [, array $options ] )
第1引数 $password は生パスワード、第2引数 $algo はハッシュアルゴリズム定数、第3引数は $options アルゴリズムがサポートするオプションを入力する。ハッシュアルゴリズムをArgon2idをするだけであれば、$algoに PASSWORD_ARGON2ID を指定するだけでよい。
<?php
    $raw_passwd = '3kanmarusan_Passw0rd';

    $hashed_passwd = password_hash($raw_passwd, PASSWORD_ARGON2ID);
# 生成されたハッシュ
$argon2id$v=19$m=1024,t=2,p=2$SEJ2M2VNL3B5MXZNN0tDYg$44a3kX0OxiFzoy4bCtkHnAyy7/TVkvIVU7kdyj8ewCg
$argon2idで始まっているので、Argon2idっぽい。$m=1024,t=2,p=2がハッシュ化時に使用しているパラメータ。これはPHPで定義されたデフォルト値そのものである(前述)。ハッシュアルゴリズムが使うメモリコスト(メモリ使用量)と時間コスト(回数)と並列度(ハッシュ化時に利用するCPUスレッドの数)をパラメータはArgon2iの時と同じである。
ちなみに、ハッシュアルゴリズムのデフォルト(PASSWORD_DEFAULT)に変更があるか調べたところ、PHP7.3の段階でも変更がないようだ。
# PASSWORD_DEFAULTはまだbcryptということを調べる
<?php
  echo "[constants]" . PHP_EOL;
  echo " PASSWORD_BCYRPT: "  . PASSWORD_BCRYPT  . PHP_EOL;
  echo " PASSWORD_ARGON2I: "  . PASSWORD_ARGON2I  . PHP_EOL;
  echo " PASSWORD_ARGON2ID: "  . PASSWORD_ARGON2ID  . PHP_EOL;
  echo " PASSWORD_DEFAULT: " . PASSWORD_DEFAULT . PHP_EOL;
# 実行結果
[constants]
 PASSWORD_BCYRPT: 1
 PASSWORD_ARGON2I: 2
 PASSWORD_ARGON2ID: 3
 PASSWORD_DEFAULT: 1
password_verify, password_get_info, password_needs_rehash
ここは変更なし
(再掲)TL;DR
visiting NTT history center of technologies
(please find the Japanese translation after the English text)
Last Friday, I visited the NTT history center of technologies with my family.
The telephone switchboard, the first generation pager and mobile phone, ISDN service, and so on, all their history and technologies excited me.
Especially, I was interested in two exhibit.
The first one was the incident of fire in a cable tunnel of the Setagaya office in 1984 and measures of preventing. I believe it would be helpful to my work.
The second one was the material of 'call processing state transition diagram and flowcharts'. The material fired up my heart as a professional engineer.
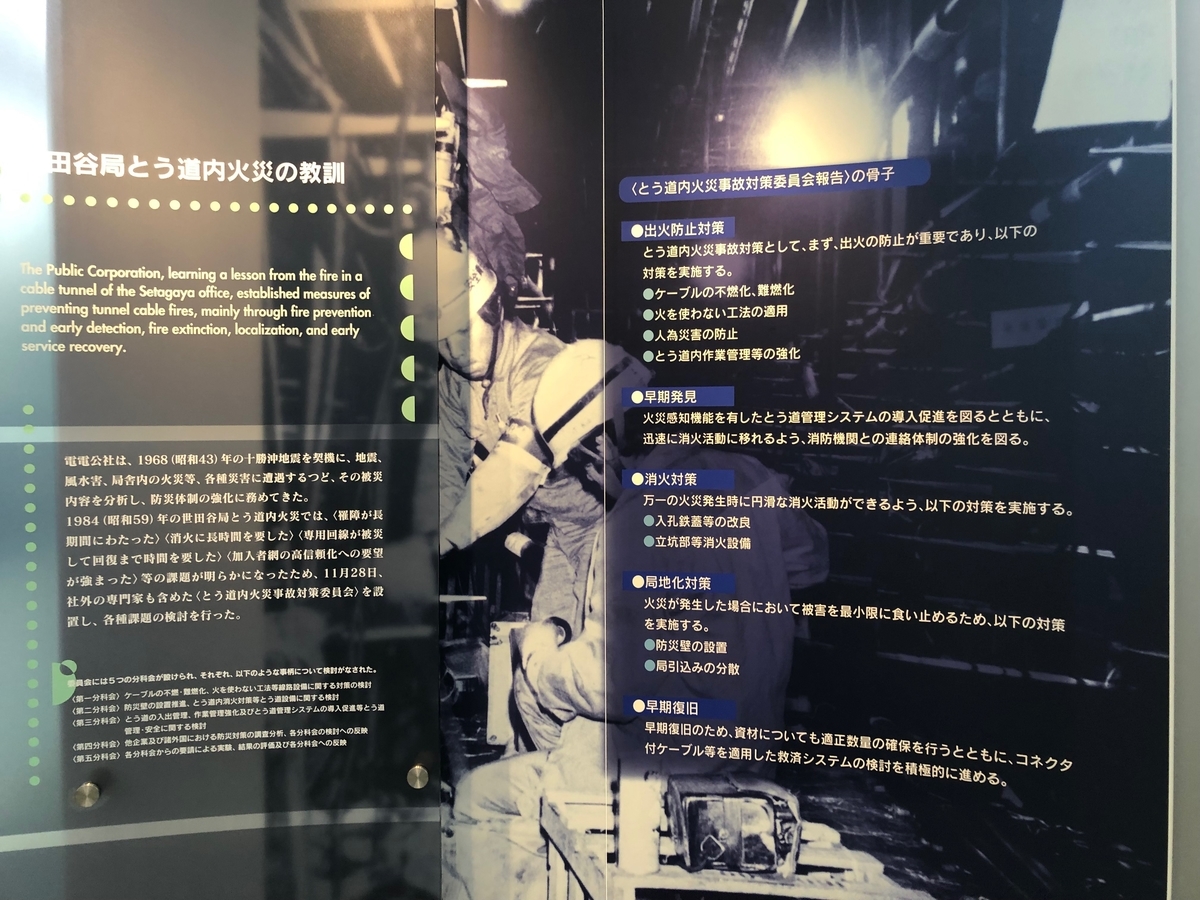
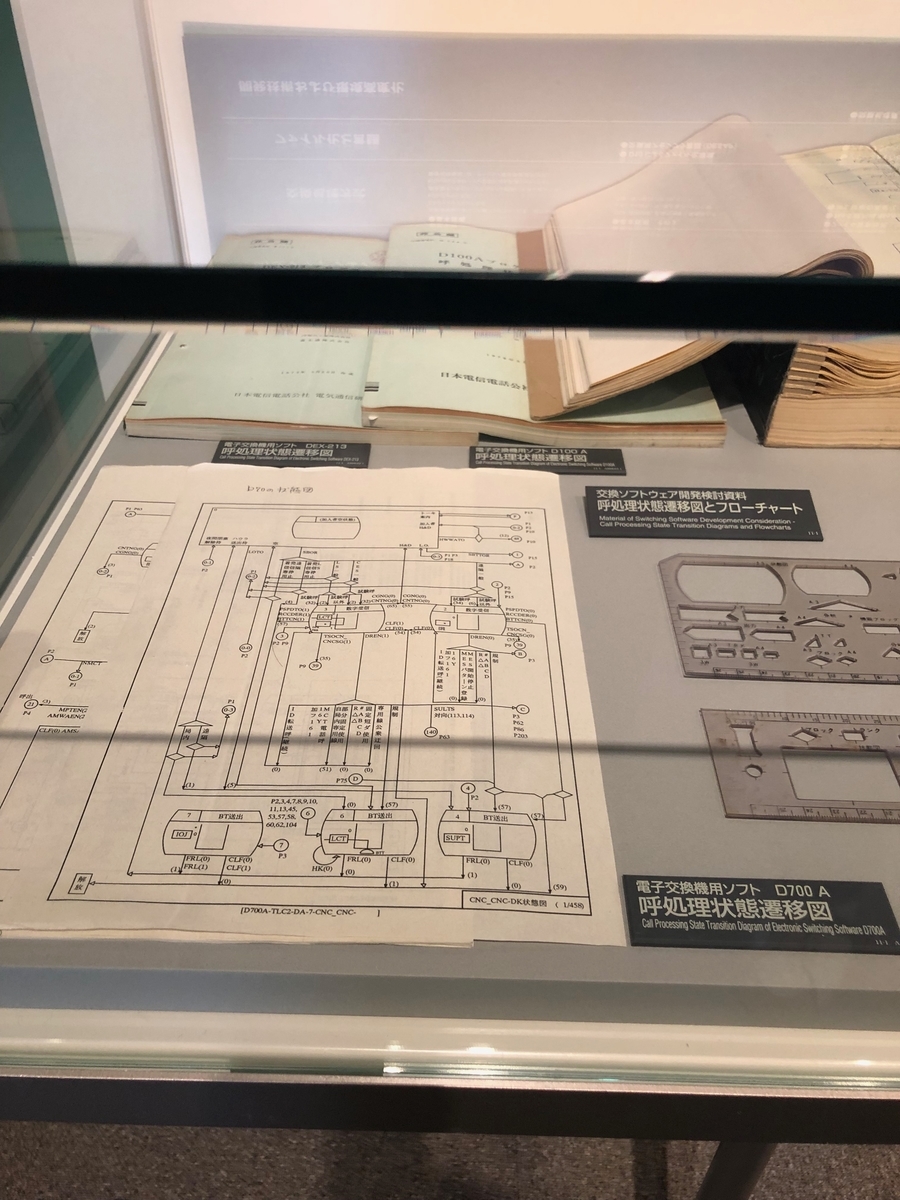
I recommend to visit 'NTT history center of technologies'. I think it's worth for you.
先週の金曜日、家族で NTT技術史料館 に行った。
電話の交換機、初期のポケベルや携帯電話、ISDNサービス、などなど、多くの歴史や技術に興奮した。
特に2つの展示に非常に興味を持った。
1つ目は、1984年に起きた世田谷のとう道の火災事故とその対策の話。これは自分の仕事にきっと役立つと思う。
2つ目は、呼制御の状態遷移図とフローチャートの資料である。これらの資料はエンジニア魂に火をつけるものだった。
NTT技術史料館はおすすめ、行く価値があると思う。
[メモ]geocitiesの静的サイトをGitHub Pagesでホスティングする
Yahoo! ジオシティーズが2019/3/31に終了する。 info-geocities.yahoo.co.jp
自分も20年近くのジオシティーズユーザーで、サイト上に黒歴史も沢山残っている。ただインターネットを彩った歴史の一部ではあると思っている。今回はこれ何かの形で残したい。
自分は、ジオシティーズの有料付加サービスであるジオプラスを利用していない。CGIを利用していないからである。つまり、HTML/CSS/JavaScript/画像のみで構成された静的サイトだということだ。ということは、さくらやロリポップ!などのレンタルサーバだと明らかにオーバースペックである。
また古い情報のHTMLといえども、エンジニアとしてバージョン管理をしないのは悲しい。ということで、GitHub Pagesでホスティングできないのかと考え、移行した時のメモを記す。作業環境は macOS High Sierraである。
ちなみにGitHubの What is GitHiub Pages? にも下記の通り書かれているので、okだと思う。
GitHub Pages is a static site hosting service designed to host your personal, organization, or project pages directly from a GitHub repository.
TL;DR
geocitiesの静的サイトはGitHub Pagesでホスティングすることが可能
手順はたったの4つ
- ftpでgeocitiesのファイルを吸い出す
- ホスティング用のプロジェクト(レポジトリ)を作り、ここに1で取得したファイルを置く
- ファイルを調整し(エンコーディングの変更、不要なファイルの削除など)masterへpush
- プロジェクトのsettingsで、masterブランチからGitHub Pagesを生成する
1. ftpでgeocitiesのファイルを吸い出す
まずはftpで思って叩いてみるといきなり死。
macOS High Sierraから/usr/bin配下のftpやtelnetなどはセキュリティ上の理由で廃止されたらしい。
bash-3.2$ ftp
bash: ftp: command not found
Homebrewでftpを復活させる。passiveモードになっていなくてファイヤウォールで叩き落とされていたりして解決まで時間がかかった。むしろ面倒だったら、CyberduckやFileZillaのようなftpソフトでやる方が早いし正確な気がする。
# ftpを使えるようにする
brew install inetutils
2. ホスティング用のプロジェクト(レポジトリ)を作り、ここに1で取得したファイルを置く
GitHub PagesでホスティングしたときのURLはこのようになるので(ドメインなど割り当てなければ)
https://{username}.github.io/{repos}
適したrepos名のレポジトリを作り、1で取得したファイルをそのまま置く。
3. ファイルを調整し(エンコーディングの変更、不要なファイルの削除など)masterへpush
自分の場合は、htmlファイルがShift_JISで書かれていた。GitHubのエンコーディングはUTF-8っぽい(あまり調べていない)のでUTF-8に変換。 必要があれば改行コードも変えておく。
# UTF-8に変換
find . -name "*.html" | xargs nkf --overwrite -w
さらにhtmlファイル内部のcharsetもutf-8に修正する。 ここで黒歴史を消すこともお忘れなく。
4. プロジェクトのsettingsで、masterブランチからGitHub Pagesを生成する
- https://github.com/{username}/{repos}/settings にアクセスし、下部にあるGitHub PagesのSelect sourceを"master brunch"にする。
- https://{username}.github.io/{repos} で確認する
デフォルトでhttpsになっているのがいい
